 欢欢@盖世汽车供应链
 悠悠@盖世汽车
 豆豆@盖世汽车


国外AI研究小组提出VoxFormer:基于Transformer的3D语义场景完成框架
盖世汽车讯 理解整体3D图片是自动驾驶汽车(AV)感知的重大挑战,会直接影响以后的活动,如规划和地图创建。由于传感器分辨率低以及视野小和遮挡造成的局部观察使得获取关于实际环境的精确和全面的3D信息具有挑战性。语义场景补全(SSC)是一种从稀疏观察中联合推断整个场景几何和语义的方法,旨在解决这些问题。可视区域的场景重建和受阻部分的场景幻觉是SSC解决方案必须同时处理的两个子任务。人类很容易根据不完美的观察来推理场景几何和语义。
尽管如此,现代SSC技术在驾驶场景中的性能仍然低于人类感知。LiDAR是当前SSC系统中提供精确3D几何测量的主要模式。然而,摄像头的价格更低,且可以提供更好的驾驶环境视觉指示,而LiDAR传感器成本更高且不够便携。据外媒报道,国外研究小组基于MonoScene开发出VoxFormer,对摄像头的SSC解决方案进行进一步的研究。
图片来源:arxiv.org
其中MonoScene使用密集特征投影将2D图片输入转换为3D。然而,这样的投影给出了可视区域中空的或遮挡的体素2D特征。例如,被汽车覆盖的空体素仍然会获得汽车的视觉特征。
因此,创建的3D特征在几何完整性和语义分割方面表现不佳。与MonoScene相比,VoxFormer将3D到2D交叉注意力视为稀疏查询的表示,且主要受到两个认识的启发:(1)3-D空间中的稀疏性:由于3-D空间的很大一部分通常是空的,因此稀疏表示(而不是密集表示)无疑更有效和可扩展。(2)幻觉前重建(reconstruction-before-hallucination):以重建的可见区域为起点,可以更好地完成不可见区域的3D信息。
简而言之,国际研究小组主要贡献为:
• 尖端的两阶段系统,可将照片转换为完整的3D体素化语义场景。
• 一种创新的基于二维卷积的查询建议网络,可从图片深度生成可信赖的查询。
• 一种独特的Transformer,可生成完整的3D场景表示,类似于屏蔽自动编码器(MAE)。
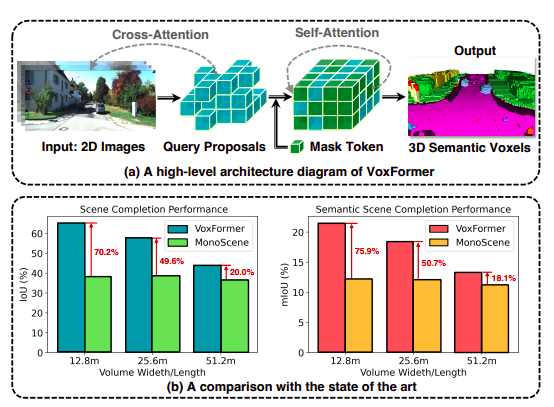
• 如图1(b)所示,VoxFormer推进了最先进的基于摄像头的SSC。
VoxFormer包括两个阶段:第1阶段建议一组稀疏的占用体素,第2阶段从第1阶段的建议开始完成场景表示。Stage 1是类不可知的,而Stage 2是类特定的。如图1(a)所示,Stage-2建立在独特的稀疏到密集的(sparse-to-dense)类MAE设计之上。特别是,stage-1包含一个基于CNN的轻量级2D查询建议网络,该网络使用图片深度重建场景几何。然后,在整个视野中,它会使用预设的可学习体素查询来建议体素的稀疏集合。
他们首先通过使建议的体素关注图片观察来加强特征化。在将非提议的体素连接到可学习的掩码标记后,剩余的体素将通过自注意力进行处理,以完成每个体素语义分割的场景表示。根据对大规模SemanticKITTI数据集的大量实验,VoxFormer提供了最先进的几何补全和语义分割性能。更关键的是,如图1所示,在安全关键的短距离位置中优势很大。


